Benchmarking JavaScript : mesurer le code sans biais
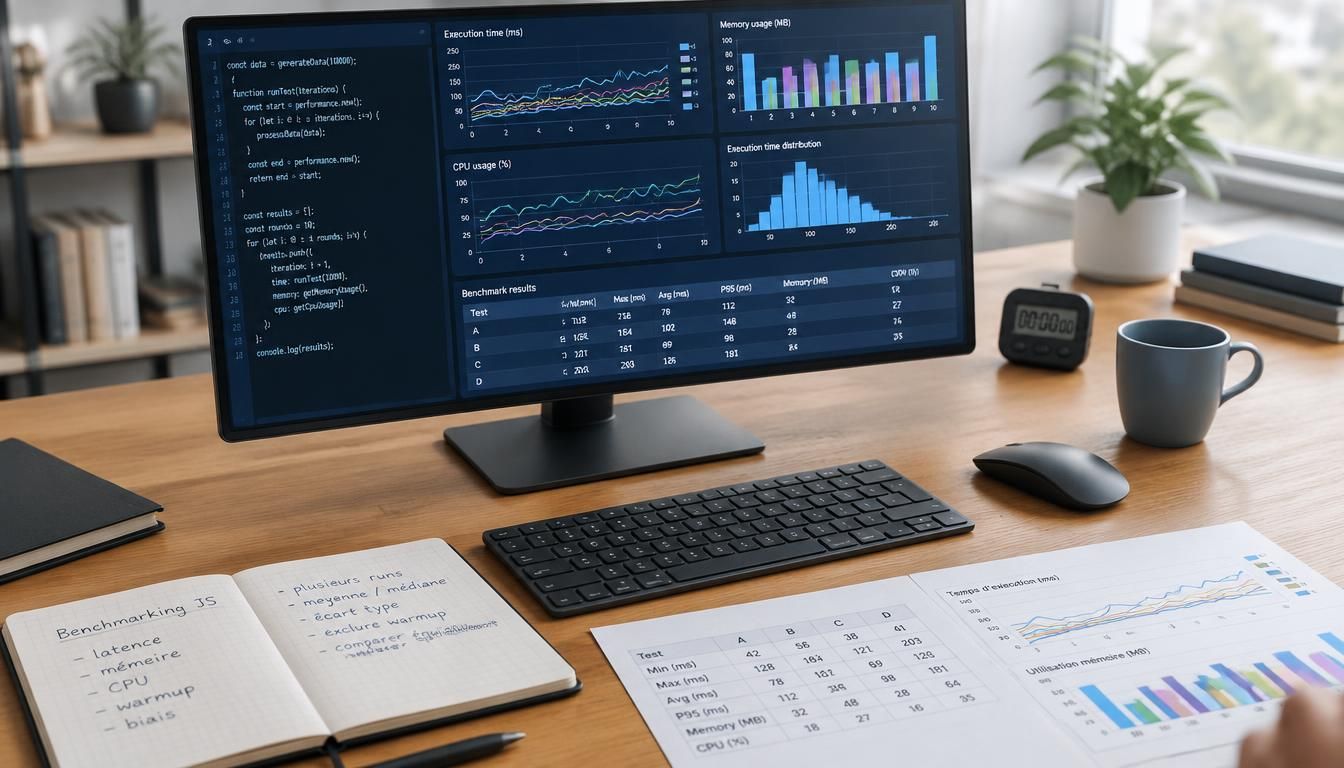
Le benchmarking JavaScript représente une méthode de mesure qui aide à comprendre comment votre code se comporte face à une charge donnée. Quand vous cherchez une solution plus rapide, il ne suffit pas de regarder le résultat final : il faut aussi vérifier ce qui se passe pendant l’exécution. Cette approche permet d’évaluer la performance, de limiter l’overhead et de choisir une méthode fiable. En pratique, elle facilite la comparaison d’une application, d’une fonction ou d’un algorithme, et garantit un check plus objectif avant de modifier votre code.
Dans un projet réel, un benchmark bien construit évite les intuitions trompeuses. Vous pouvez tester un tri, une recherche ou un parsing, puis observer si un code devient vraiment faster après optimisation. Le benchmarking JavaScript sert alors de méthode de contrôle, avec un result mesurable et reproductible. C’est essentiel lorsque vous devez décider entre deux options proches, car la solution la plus élégante n’est pas toujours la plus efficace.
Comprendre le test de performance avant de comparer des solutions
Avant de comparer deux approches, il faut savoir ce que vous mesurez vraiment. Un benchmark ne dit pas seulement “cette version gagne”, il montre aussi où se situe le coût réel. Si vous avez déjà résolu un problem de tri sur un file volumineux, vous pouvez ensuite comparer une solution avec une autre pour savoir laquelle reste la plus stable. Dans ce contexte, la version 1 peut sembler suffisante, mais la version 2 devient parfois plus intéressante quand les données augmentent.
Le tableau ci-dessous résume la différence entre une mesure brute et une comparaison de solutions. C’est cette this distinction qui aide you à lire un result sans vous tromper. Une méthode isolée sert à observer le comportement, tandis qu’un benchmark compare plusieurs variantes sur un même file de test. Ainsi, you voyez si une solution est réellement meilleure ou seulement plus rapide dans un cas sampled.
| Mesure brute | Comparaison de solutions |
|---|---|
| Un seul code testé | Plusieurs versions face au même scénario |
| Lecture locale | Décision plus fiable |
Ce qu’un benchmark mesure vraiment
Un benchmark mesure le temps, parfois les opérations par seconde, et surtout la régularité entre plusieurs exécutions. Il ne juge pas seulement une solution, il observe un comportement sous contrainte. Sur un file de données, une version peut sembler sampled plus rapide au premier essai, puis perdre son avantage au second passage. C’est pour cela qu’un benchmark reste un outil de lecture, pas un verdict absolu.
Pourquoi comparer plusieurs implémentations
Comparer plusieurs méthodes devient utile dès qu’une version fonctionne déjà. Vous pouvez alors vérifier si une autre implementation réduit le temps, le coût mémoire ou la variabilité. Dans un cas sampled, une première méthode peut être simple, mais une autre version peut s’avérer meilleure sur de gros volumes. Le but n’est pas de chercher un vainqueur unique, mais de choisir la solution la plus adaptée à votre contexte.
Préparer un protocole fiable pour mesurer le code
Un test sérieux commence par un environnement propre. Si vous installez la même suite d’outils sur la même machine, vous réduisez les écarts inutiles. Ensuite, installez les dépendances une seule fois, puis gardez le même code et les mêmes données pour toutes les runs. Cette méthode sampled aide à obtenir un support de mesure plus stable, sans biais lié à l’installation ou à la configuration.
Voici cinq étapes simples pour construire un test reproductible : définissez la question, préparez les données, installez l’environnement, lancez plusieurs fois le code, puis comparez les times. Répétez au moins second fois la séquence pour vérifier la cohérence. Si le dernier run diverge fortement, le result mérite d’être relu. Cette méthode sampled ne supprime pas tous les écarts, mais elle évite de conclure trop vite.
- Choisir un seul objectif de mesure et un seul type de charge.
- Installer les mêmes dépendances avant chaque série.
- Garder les mêmes données d’entrée et la même taille.
- Lancer plusieurs fois le code pour lisser les écarts.
- Comparer les times en gardant le même support d’exécution.
Les étapes d’un protocole reproductible
Commencez par un scénario clair, puis préparez un jeu de données identique. Installez les outils nécessaires, exécutez la suite de tests, et notez les times obtenus. Ensuite, répétez la série au second passage pour voir si le résultat sampled reste cohérent. Cette discipline vous évite de confondre une bonne surprise ponctuelle avec une vraie amélioration.
Les erreurs qui faussent les mesures
Les biais les plus fréquents viennent du warm-up, du cache et des tâches en arrière-plan. Si vous installez un outil puis le lancez une seule fois, vous risquez de mesurer un démarrage inhabituel. Un code peut aussi sembler meilleur parce qu’il a été exécuté après un autre, ou parce que la suite n’était pas vide. C’est ce problème sampled qui rend la répétition indispensable.
Choisir l’outil adapté à votre environnement d’exécution
Le bon outil dépend de votre contexte. En ligne, vous pouvez tester rapidement un benchmark sans rien installer, mais la comparaison reste limitée. Avec un script Node.js, vous contrôlez mieux la version et le file de test. Dans un navigateur, vous observez un comportement proche d’une application réelle, alors qu’un REPL permet d’itérer vite. Chaque méthode a son usage, et une seule ne suffit pas toujours.
Si vous devez install un outil localement, vérifiez la version du runtime et la suite de dépendances. Une version récente peut donner un result différent d’une autre, même avec le même code. Pour un support simple, un REPL convient bien à un test rapide ; pour une application plus lourde, Node.js reste souvent plus pratique. Ce choix sampled dépend donc du contexte, pas d’une préférence abstraite.
| Contexte | Usage conseillé |
|---|---|
| Outil en ligne | Test rapide et partage facile |
| Node.js | Mesure contrôlée et automatisée |
| Navigateur | Scénario proche d’une application web |
| REPL | Itérations courtes et comparaison immédiate |
Outils simples pour tester rapidement
Pour un premier benchmark, un outil en ligne suffit souvent. Vous y collez un code court, vous lancez la suite, puis vous observez le result sans config lourde. Si vous voulez install quelque chose de plus stable, un script local devient plus pertinent. Le plus important reste la cohérence du support et la clarté de la méthode sampled.
Quand préférer Node.js, le navigateur ou un REPL
Node.js convient bien aux traitements serveur et aux scripts autonomes. Le navigateur est préférable quand votre application dépend du DOM ou d’événements utilisateur. Le REPL, lui, aide à vérifier une version après l’autre, surtout pour un code court. Selon le support, une même méthode peut montrer un result différent, donc le choix doit suivre le cas d’usage.
Lire les chiffres sans se tromper sur les gains réels
Un bon chiffre ne suffit pas : il faut savoir le lire. Si une version affiche 120 000 ops/sec et une autre 118 500, l’écart peut sembler faible. Pourtant, le bruit de mesure peut expliquer cette différence. Pour interpréter un résultat sampled, observez la stabilité, la répétition et le contexte d’exécution. Le but n’est pas seulement de trouver faster, mais de comprendre si le gain est réel.
Voici cinq critères utiles : l’écart moyen, la dispersion, la répétition, le support utilisé et l’effet de l’overhead. Si toutes les séries sampled racontent la même chose, le result est plus crédible. En revanche, si une version gagne seulement une fois sur trois, elle n’est pas forcément meilleure. C’est alors que vous devez relire la méthode et vérifier si le gain est significatif ou simplement bruité.
- Regarder l’écart moyen entre les versions comparées.
- Vérifier la dispersion des mesures sur plusieurs runs.
- Comparer les résultats sur le même support d’exécution.
- Contrôler l’overhead lié à l’outil ou au runtime.
- Ne conclure qu’après plusieurs séries sampled cohérentes.
Différence entre gain réel et bruit statistique
Un gain réel se répète dans toutes les séries, alors qu’un bruit statistique disparaît dès qu’on relance le test. Si la version faster n’est meilleure que sur un seul essai, elle ne mérite pas encore votre confiance. Le dernier run peut être influencé par le cache, la température machine ou une tâche annexe. C’est pourquoi un résultat sampled doit être lu avec prudence.
Pourquoi le plus rapide n’est pas toujours le meilleur
La solution la plus rapide n’est pas toujours la plus utile. Une version peut gagner en vitesse, mais perdre en lisibilité, en maintenance ou en robustesse. Dans une application réelle, ce compromis compte autant que le chiffre. Si l’overhead reste faible et que la méthode est simple, le choix peut être meilleur même sans record. Le benchmark sampled aide donc à arbitrer, pas à sacrer un champion.
Optimiser un algorithme sans tomber dans le piège du micro-test
Prenons un exemple simple : une function qui parcourt des arrays pour filtrer des valeurs et calculer un total. Vous testez une première solution avec une boucle classique, puis une autre avec une approche plus compacte. Sur le papier, la seconde semble meilleure, mais le problem change quand le volume augmente. Une application réelle supporte rarement un seul cas d’usage, donc la performance doit être validée au-delà du micro-test.
Dans cet example, la version A prend 18 ms pour 10 000 éléments et 9 800 ops/sec, tandis que la version B descend à 12 ms et 14 200 ops/sec. Sur une autre série, pourtant, la différence se réduit. C’est là que la suite de tests doit confirmer le gain. Si vous avez une solution plus rapide, vérifiez toujours le contexte sampled avant d’en faire une règle générale.
| Version | Temps moyen |
|---|---|
| Function A | 18 ms |
| Function B | 12 ms |
Quand une optimisation vaut vraiment la peine
Une optimisation mérite votre attention quand elle touche un point chaud, un calcul répété ou une boucle coûteuse. Si la performance ne change presque pas, la solution la plus lisible reste souvent préférable. Une function plus complexe peut aussi créer un autre problem de maintenance. Le bon benchmark sampled vous aide à décider sans sur-optimiser.
Comment valider un résultat dans un cas réaliste
Validez toujours l’amélioration avec des données proches de la production. Gardez les mêmes arrays, la même taille et le même support d’exécution. Puis relancez la suite dans un contexte proche de l’application réelle. Si le dernier test confirme le gain, vous pouvez garder la solution. Sinon, revenez à une version plus simple et plus sûre.
FAQ – Questions fréquentes sur la mesure des performances JavaScript
Qu’est-ce qu’un benchmark JavaScript utile en pratique ?
C’est un test qui compare un code dans des conditions proches de son usage réel. Il permet de vérifier une solution, pas seulement de produire un chiffre sampled.
Faut-il répéter les tests plusieurs fois ?
Oui, toujours. Une seule exécution peut tromper à cause du cache, du warm-up ou d’un bruit ponctuel. Répétez pour obtenir un result plus fiable.
Un micro-benchmark suffit-il pour conclure ?
Non. Il aide à observer une opération précise, mais il ne remplace pas un test plus large. Une solution peut sembler meilleure sur un point et moins bonne ailleurs.
Comment savoir si un gain est réellement significatif ?
Comparez plusieurs séries, observez la dispersion et vérifiez que l’écart se maintient. Si le résultat sampled reste stable, le gain a plus de chances d’être réel.