
Tests de benchmark : mesurer, comparer et interpréter
 Pierrick
•
20 octobre 2026
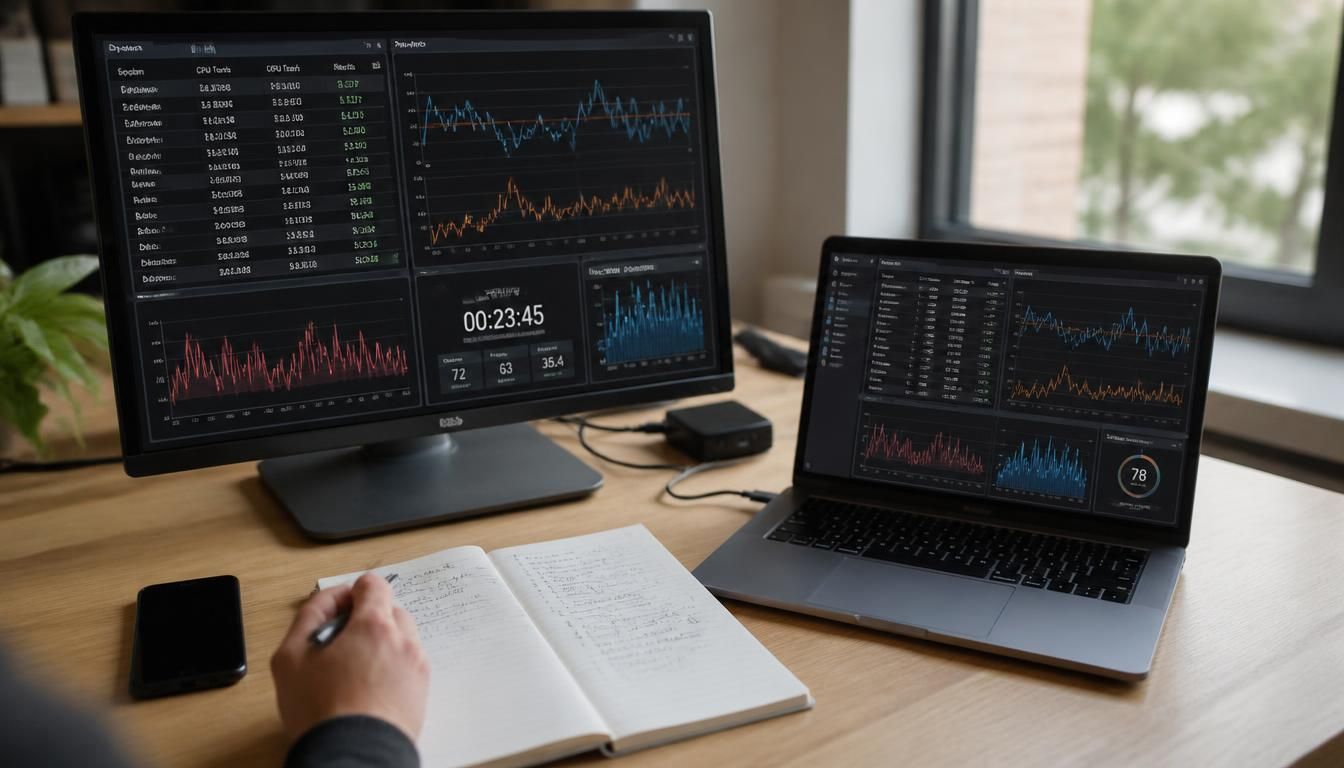
Quand votre système ralentit sans raison apparente, la vraie question n’est pas seulement « est-ce normal ? », mais « par rapport à quoi ? ». C’est là que les benchmarking tests représentent un repère essentiel : ils mesurent une base de performance, puis servent à comparer, interpréter et décider. En pratique, ce cadre de mesure facilite l’analyse d’un benchmark, d’un test de charge ou d’un simple contrôle de performance. Vous allez voir comment établir une baseline, comparer avant et après un changement, lire les résultats et éviter les erreurs qui faussent le testing.
Le principe est simple : vous fixez un point de départ, vous lancez un test dans des conditions connues, puis vous observez l’écart. Cette méthode est précieuse pour un logiciel, une application ou un système complet, car elle permet de vérifier si une modification améliore vraiment la performance ou si elle crée une régression. Dans les lignes qui suivent, vous allez apprendre à préparer l’environnement, choisir le bon type de test, interpréter les métriques et adopter des bonnes pratiques reproductibles.
Comprendre le test de référence et son rôle
Un test de référence sert à mesurer un état initial, puis à le comparer à un autre moment. Dans la pratique, on parle de benchmark quand on cherche une base stable pour évaluer la performance d’un système, d’une application ou d’un logiciel. Le testing devient alors un outil de décision : il aide à mesurer un résultat, à vérifier un objectif et à comparer deux versions. La baseline, elle, correspond au point de départ. Sans elle, la comparaison perd son sens et le test ne dit plus grand-chose sur le système.
La nuance est importante. Le benchmark vise la référence, le performance testing examine le comportement global, et le test de charge pousse le système sous pression. Un benchmark peut donc servir à mesurer la vitesse, la stabilité ou la capacité d’un logiciel, alors qu’un test de charge cherche surtout à voir jusqu’où l’application tient. Pour un lecteur débutant, l’idée est simple : vous ne demandez pas la même chose à chaque test. L’objectif change, donc la baseline et le résultat attendu changent aussi.
Ce que signifie vraiment une baseline
La baseline est le point fixe qui vous évite de comparer des choses incomparables. Si vous testez une application un lundi et la même application après une mise à jour, cette base sert à mesurer l’écart réel. Dans un benchmark, elle permet de relier une mesure à une situation précise. Pour un système, une baseline bien choisie réduit le bruit, clarifie le résultat et donne un repère fiable au testing. Sans cette base, le benchmark devient une simple photo isolée, difficile à interpréter.
Pourquoi comparer avant et après un changement
Comparer avant et après un changement permet d’identifier ce qui a vraiment bougé. Vous installez un nouveau logiciel, vous modifiez un paramètre, puis vous relancez le test : la comparaison montre si la performance progresse ou se dégrade. C’est utile pour un système, une application ou un logiciel de production, car vous savez alors si l’objectif est atteint. Le benchmark devient ainsi un garde-fou : il évite d’attribuer une amélioration au hasard et vous aide à mesurer l’effet réel d’une action.
Préparer un environnement fiable avant de lancer l’essai
Avant tout test, il faut stabiliser le système. Sinon, le résultat varie d’un run à l’autre et la baseline perd sa valeur. Commencez par figer la configuration du logiciel, vérifier le hardware et noter les conditions de départ. Un outil de mesure n’est utile que si l’environnement reste identique. Dans cette phase, la gestion des tâches en arrière-plan compte autant que le choix du test, car un service lancé au mauvais moment peut fausser la lecture.
Pour assurer un essai propre, standardisez aussi les paramètres matériels et logiciels. Un même système peut réagir différemment selon la mémoire disponible, la température du hardware ou la version du logiciel. C’est pourquoi il faut une configuration reproductible, avec des conditions connues avant chaque phase. Le but n’est pas de créer un environnement parfait, mais un environnement cohérent. Si vous répétez le test dans les mêmes conditions, le benchmark devient plus crédible et la comparaison plus nette.
Les variables qui faussent les résultats
Les variables parasites sont souvent discrètes, mais elles changent tout. Une mise à jour automatique, un antivirus actif, un service réseau ou une tâche de fond peuvent modifier le système sans prévenir. Même le hardware peut introduire des écarts si la température monte ou si l’alimentation varie. Dans un test, ces détails comptent. Pour éviter les biais, il faut assurer la stabilité du logiciel, du système et de l’outil utilisé, puis répéter le run plusieurs fois pour repérer les anomalies.
Comment standardiser une configuration de départ
Standardiser une configuration de départ, c’est définir une base commune avant chaque test. Vous choisissez le même logiciel, la même version du système, le même hardware et les mêmes réglages. Cette phase de préparation facilite la gestion du benchmark et limite les écarts entre deux runs. L’idée est simple : si tout change en même temps, le test ne prouve rien. Si vous fixez les conditions de départ, vous pouvez ensuite assurer une comparaison propre et exploitable.
- Vérifier la version du système et du logiciel
- Fermer les tâches non nécessaires avant le test
- Contrôler l’état du hardware et de la mémoire
- Documenter les paramètres de configuration
- Lancer un run de validation avant la mesure finale
Mesurer l’impact d’une mise à niveau ou d’un changement
Quand vous changez un composant, le benchmark sert à mesurer l’effet concret de cette évolution. Un nouveau cpu, plus de mémoire ou un stockage plus rapide peuvent modifier la performance, mais encore faut-il le prouver. Le test avant/après permet de comparer la capacité du système, sa vitesse et sa stabilité. Dans un contexte de production, ce type de benchmark évite les impressions vagues : vous voyez si le changement apporte un vrai gain ou seulement une sensation de fluidité.
On utilise souvent ce test après un upgrade matériel, mais il est tout aussi utile après une optimisation logicielle. Vous pouvez mesurer l’impact d’un nouveau pilote, d’un réglage d’OS ou d’une amélioration applicative. Le résultat devient alors un indicateur de décision. Pour un cpu, par exemple, on regarde la vitesse de calcul ; pour le stockage, on observe les temps d’accès ; pour le système complet, on compare la performance globale et la capacité à tenir la charge.
Après un upgrade matériel
Après une mise à niveau matérielle, le benchmark montre si le gain annoncé se retrouve dans l’usage réel. Un cpu plus rapide n’améliore pas toujours tout, surtout si le disque ou la mémoire limitent le système. Le test permet donc de mesurer la vitesse, la capacité et l’équilibre général. En production, cette comparaison aide à valider un achat ou à confirmer qu’un changement matériel répond bien à l’objectif fixé.
Après une optimisation logicielle
Après une optimisation logicielle, le test sert à vérifier que l’amélioration n’est pas seulement théorique. Une application mieux réglée peut afficher un meilleur benchmark, mais aussi réduire les temps d’attente et améliorer la performance perçue. Ici, la comparaison avant/après est essentielle : elle montre si le système répond plus vite, si le cpu est mieux utilisé et si le résultat reste stable. C’est souvent là que le benchmark prend toute sa valeur, car il relie l’optimisation à un effet mesurable.
- Après un changement de cpu ou de mémoire
- Après une mise à jour du système
- Après une optimisation d’application
- Après une modification de stockage ou de pilote
Choisir les bons types d’essais selon l’objectif
Il existe plusieurs formes de benchmark, et le bon choix dépend de votre objectif. Un test matériel ne répond pas à la même question qu’un test applicatif, ni qu’un test de charge. Le benchmark peut être synthétique, c’est-à-dire basé sur des scénarios contrôlés, ou plus proche des conditions réelles. Dans une application, le testing sert souvent à vérifier une fonctionnalité précise ; dans un système, il aide à mesurer une performance globale ; dans une app, il peut révéler une faiblesse de charge.
Le plus important est d’aligner le test avec le besoin. Si vous voulez évaluer un logiciel, un benchmark fonctionnel peut suffire. Si vous voulez observer la résistance d’un système sous pression, la charge devient centrale. Et si vous cherchez à comparer deux versions d’une app, le dataset utilisé doit rester identique. Le benchmark n’est donc pas un exercice unique, mais une famille de tests adaptés à des objectifs différents.
| Type de benchmark | Usage principal |
|---|---|
| Synthétique | Mesurer une performance standardisée dans un environnement contrôlé |
| Applicatif | Évaluer une fonctionnalité ou une app en usage proche du réel |
| Charge | Observer le comportement d’un système sous forte sollicitation |
| Matériel | Comparer les capacités d’un composant ou d’un système complet |
Tests synthétiques ou conditions réelles
Un test synthétique est utile pour comparer vite et proprement, mais il ne reflète pas toujours l’usage réel. À l’inverse, un benchmark basé sur des conditions réelles montre mieux la manière dont une application se comporte au quotidien. Dans le testing, les deux approches se complètent. Le premier donne une base claire, le second apporte du contexte. Si vous cherchez un résultat facile à comparer, partez sur un benchmark synthétique ; si vous cherchez un usage concret, privilégiez un scénario réel.
Benchmark applicatif ou benchmark serveur
Le benchmark applicatif se concentre sur une fonctionnalité, une app ou un logiciel précis. Le benchmark serveur, lui, regarde la réponse du système sous charge, souvent avec plusieurs requêtes et un dataset plus large. L’un parle d’usage métier, l’autre de capacité technique. Pour choisir, demandez-vous ce que vous voulez évaluer : la fluidité d’une application ou la tenue d’un système complet. Cette question simple évite bien des comparaisons trompeuses.
Interpréter les scores et éviter les mauvaises conclusions
Un score de benchmark attire l’œil, mais il ne dit pas tout. Le résultat brut doit être replacé dans son contexte, car une performance élevée sur un point peut cacher une faiblesse ailleurs. Les metrics comme le throughput, le time de réponse ou la stabilité aident à identifier ce qui progresse vraiment. Le benchmark n’est donc pas une simple note : c’est un ensemble d’indices à évaluer avec méthode. Sans cette lecture, on peut surestimer un gain ou sous-estimer une régression.
Pour bien lire les results, il faut relier chaque chiffre à une question précise. Est-ce que le système répond plus vite ? Est-ce que le throughput augmente ? Est-ce que le temps d’exécution baisse sans dégrader l’expérience ? Ces questions permettent d’identifier ce qui compte vraiment. Un benchmark bien interprété vous aide à évaluer la performance globale, mais aussi à comprendre l’effet d’un composant sur l’ensemble du système.
Ce qu’un score ne dit pas toujours
Un score ne dit pas toujours si l’usage est agréable. Vous pouvez obtenir un bon résultat et pourtant ressentir une lenteur dans l’application. Pourquoi ? Parce que le benchmark mesure une partie de la performance, pas toute l’expérience. Il faut donc under la surface du score et regarder les metrics secondaires. Le rôle du test est d’identifier les écarts, pas de tout résumer en un seul nombre. C’est aussi pour cela qu’il faut ensure une lecture prudente des résultats.
Comment relier les chiffres à l’usage réel
Pour relier les chiffres à l’usage réel, posez une question simple : que ressent l’utilisateur au quotidien ? Si le time d’ouverture baisse, mais que l’application reste instable, le gain est limité. Si le throughput monte sans hausse de latence, le benchmark est plus convaincant. Cette approche permet d’évaluer la performance sous un angle utile, pas seulement théorique. En pratique, un bon résultat doit correspondre à un bénéfice visible dans le système ou le logiciel.
- Comparer le score global et les métriques détaillées
- Vérifier si le résultat correspond à l’usage attendu
- Identifier les écarts entre performance brute et ressenti
- Contrôler si la comparaison repose sur les mêmes conditions
Les outils et métriques qui font la différence
Le bon outil change tout, parce qu’il détermine la qualité de la mesure. Un benchmark simple peut suffire pour un usage ponctuel, mais un test plus avancé devient utile dès que vous devez suivre plusieurs metrics. Selon le contexte, l’outil doit mesurer la performance, le throughput, la latence, le temps d’exécution ou la consommation de ressources. Pour un pc, on surveille souvent le cpu, la mémoire et le disque ; pour une application, on regarde aussi la réponse fonctionnelle et la stabilité du software.
Le choix dépend donc du niveau de détail recherché. Un outil léger aide à lancer un test rapide, tandis qu’un outil plus avancé permet d’analyser plusieurs metrics en parallèle. Dans une application ou un système plus complexe, il faut parfois croiser les mesures pour comprendre l’origine d’un ralentissement. Le benchmark devient alors un tableau de bord, pas juste un score. L’essentiel est de choisir un outil adapté à votre besoin, à votre rythme et à votre niveau technique.
- Vérifier les metrics disponibles et leur précision
- Choisir un outil adapté au système visé
- Contrôler la simplicité d’usage et la reproductibilité
- Comparer les résultats sur plusieurs runs
Choisir un outil simple ou avancé
Un outil simple convient si vous voulez un test rapide, sans configuration lourde. Un outil avancé devient utile quand vous devez suivre la performance sur plusieurs couches du système. Dans un benchmark applicatif, cette différence compte beaucoup : le premier donne une vue d’ensemble, le second aide à identifier une latence, un goulot ou une consommation mémoire anormale. Le bon choix dépend donc du niveau d’analyse attendu et du temps que vous pouvez consacrer au test.
Les métriques à suivre selon le contexte
Sur un pc, surveillez le cpu, la mémoire et le disque. Sur une application, ajoutez la latence, le temps de réponse et la stabilité. Sur un serveur, le throughput et la charge deviennent prioritaires. Chaque contexte appelle ses propres metrics, et le benchmark ne doit pas tout mélanger. Si vous suivez les bons indicateurs, vous obtenez un résultat plus lisible et plus utile pour décider. C’est souvent là que l’outil fait la différence entre une mesure vague et une vraie analyse.
Bonnes pratiques pour des essais reproductibles
Un test reproductible est un test que vous pouvez relancer sans changer son sens. Pour y parvenir, il faut assurer la stabilité du system, garder le même software et limiter les écarts entre chaque run. Dans une équipe de development, cette rigueur évite les débats sans fin. En production, elle permet de vérifier qu’un benchmark reflète bien un état réel. Le nombre de variables doit rester faible, sinon le résultat devient difficile à interpréter.
La logique est simple : répéter, documenter, comparer. Si vous relancez le test dans la même phase, avec la même baseline et les mêmes conditions, vous réduisez les écarts parasites. Cela vaut aussi pour le support technique, qui doit pouvoir relire les mesures sans deviner ce qui a changé. Un benchmark bien documenté devient un repère solide pour la team, surtout quand il faut suivre l’évolution d’un système dans le temps.
- Répéter le test plusieurs fois pour lisser les écarts
- Documenter la configuration matérielle et logicielle
- Garder le même system et le même support de mesure
- Limiter le nombre de variables entre deux runs
- Comparer les résultats dans un cadre identique
Répéter, documenter, comparer
Répéter le test permet de distinguer une vraie tendance d’un simple accident de mesure. Documenter chaque détail aide ensuite à comprendre pourquoi le benchmark a évolué. Comparer enfin les résultats donne du sens à l’ensemble. Cette méthode est simple, mais elle reste la meilleure pour assurer un suivi crédible de la performance. Dans un projet de development comme en production, elle protège des conclusions rapides et des décisions prises sur un seul chiffre.
Ce qu’il faut surveiller à chaque run
À chaque run, surveillez la version du software, l’état du system, la charge en arrière-plan et les conditions de température. Vérifiez aussi le support de stockage, car un disque saturé peut changer le test. Si le nombre de variables augmente, le benchmark perd en fiabilité. Le bon réflexe consiste à noter tout ce qui peut influencer la mesure, puis à garder ce cadre constant d’un essai à l’autre.
Cas d’usage concrets pour le matériel, le logiciel et l’IA
Dans la vraie vie, le benchmark sert à décider avant une mise en production, après une optimisation ou au moment d’un achat. Sur un hardware, il permet de vérifier si un cpu, un disque ou une carte graphique tient la performance attendue. Sur une application, il aide à évaluer la fluidité, la stabilité et la charge. Sur un modèle d’IA, il sert à comparer un dataset, un temps de réponse et la qualité du result obtenu. Le test devient alors un outil de choix, pas seulement de mesure.
Imaginez Léa, développeuse à Lyon, qui prépare une nouvelle version de son logiciel. Elle lance un benchmark avant la livraison, puis un autre après optimisation. Le premier test montre une latence trop élevée ; le second confirme un gain net. Ce type de scénario est courant, que ce soit en development ou en production. L’important reste le même : choisir un benchmark cohérent avec l’usage, puis evaluate les écarts sans forcer l’interprétation.
Pour un PC ou un composant
Pour un PC ou un composant, le benchmark mesure surtout la performance brute. Vous comparez le cpu, la mémoire, le disque ou le système complet, puis vous observez le résultat sur des tâches concrètes. Un test bien choisi peut révéler un goulot d’étranglement ou confirmer qu’un hardware est mieux équilibré. C’est souvent le cas après un changement de pièce, quand on veut evaluate le gain réel et pas seulement la fiche technique.
Pour une application ou un modèle d’IA
Pour une application ou un modèle d’IA, le benchmark doit tenir compte du dataset, de la charge et du temps de réponse. Le logiciel ne doit pas seulement être rapide : il doit rester stable, cohérent et utile dans son contexte. Un test bien construit permet de comparer deux versions, d’anticiper un risque avant production et de mesurer la qualité du résultat. Ici, le benchmark devient un outil de validation autant qu’un outil d’analyse.
- Avant une mise en production d’application
- Après une optimisation logicielle ou matérielle
- Lors d’un changement de cpu, mémoire ou disque
- Pour comparer deux versions d’un modèle d’IA
FAQ – Questions fréquentes sur les tests de benchmark
Qu’est-ce qu’un test de benchmark, en termes simples ?
Un test de benchmark est une mesure de référence qui sert à évaluer la performance d’un système, d’un logiciel ou d’une application. Il permet de comparer un état initial et un état modifié, afin d’obtenir un résultat lisible. La baseline joue ici un rôle central, car elle donne le point de départ. En pratique, ce test aide à comprendre si un changement améliore vraiment la situation.
Quelle différence entre benchmark et test de charge ?
Le benchmark mesure une performance de référence, tandis que le test de charge observe le comportement sous sollicitation. Le premier sert surtout à comparer, le second à pousser le système dans ses retranchements. Les deux sont utiles, mais ils ne répondent pas à la même question. Un benchmark peut être léger et précis ; un test de charge montre plutôt la résistance d’un logiciel ou d’une application.
Pourquoi faut-il une baseline avant de comparer ?
Sans baseline, la comparaison manque de cadre. Vous ne savez pas si le résultat observé est meilleur, identique ou moins bon qu’avant. La baseline fixe un point stable pour le benchmark et rend la lecture plus fiable. Elle aide aussi à vérifier l’effet d’un changement sur la performance réelle. C’est le repère qui transforme un simple test en outil d’analyse.
Quels indicateurs regarder en priorité ?
Regardez d’abord les métriques qui reflètent votre usage : temps de réponse, throughput, latence et stabilité. Selon le contexte, ajoutez le cpu, la mémoire ou le disque. L’idée n’est pas de tout mesurer, mais de suivre les indicateurs qui expliquent le résultat. Un bon benchmark met en avant peu de métriques, mais les bonnes. C’est souvent ce qui rend la comparaison plus claire.
Comment savoir si un résultat est fiable ?
Un résultat est plus fiable s’il se répète dans les mêmes conditions. Relancez le test plusieurs fois, gardez la même configuration et vérifiez que le système n’a pas changé entre deux mesures. Si les écarts restent faibles, le benchmark est plus crédible. Si les variations sont fortes, il faut revoir l’environnement, l’outil ou la baseline avant de conclure sur la performance.
Faut-il tester dans les mêmes conditions à chaque fois ?
Oui, sinon la comparaison perd son sens. Un test réalisé avec un autre logiciel, une autre configuration ou un système modifié ne raconte plus la même histoire. Pour un benchmark utile, les conditions doivent rester proches d’un run à l’autre. Cela ne veut pas dire figer tout le contexte, mais contrôler ce qui influence la mesure. C’est la base d’une analyse sérieuse.
Un benchmark suffit-il pour juger une application ?
Non, pas à lui seul. Un benchmark donne une excellente base, mais il ne remplace pas l’observation de l’usage réel, de la stabilité et du comportement sous charge. Une application peut obtenir un bon score tout en offrant une expérience moyenne. Il faut donc croiser le test avec d’autres métriques et avec le contexte métier. Le benchmark éclaire, mais il ne résume pas tout.
Quels outils choisir pour débuter ?
Pour débuter, choisissez un outil simple, lisible et facile à relancer. L’important est de pouvoir mesurer la performance sans perdre du temps dans la configuration. Un bon outil doit afficher clairement les résultats, permettre la comparaison et rester cohérent d’un test à l’autre. Ensuite, si vos besoins grandissent, vous pourrez passer à un benchmark plus avancé, avec davantage de metrics et de contrôle.
Vous aimerez aussi
 Tests

 Tests
 Tests
 Tests